
Gemini 3.8 TTS incorpora voces con español mexicano
Google anunció dos modelos de voz sintética y una biblioteca de más de 2,000 voces; la replicación exige consentimiento.
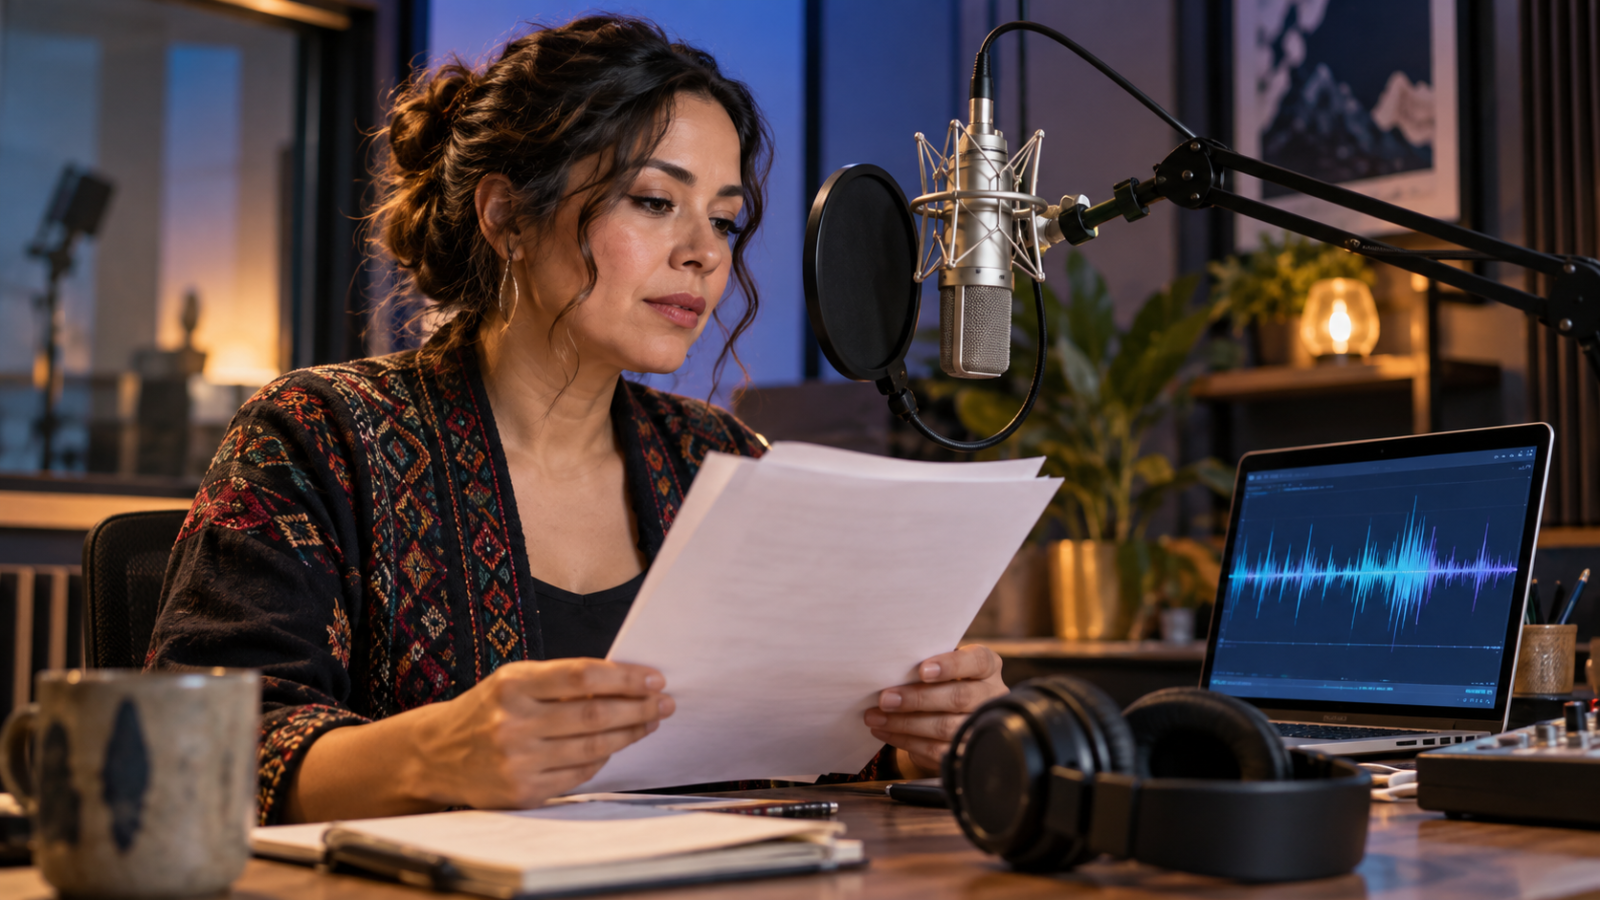
Google anunció el 23 de septiembre dos modelos de generación de voz, Gemini 3.8 Flash TTS y Flash-Lite TTS, con opciones de personalización y dirección de diálogos. La compañía incluye el español mexicano entre las variantes de su biblioteca. Para creadores y empresas en México, la novedad es una herramienta de producción, no una garantía automática de audio correcto.
TTS significa convertir texto en habla. Flash TTS se presenta como una opción para diseñar personajes y dirigir interpretaciones, mientras que Flash-Lite está orientado a producción de alto volumen. Google describe este último como eficiente en costos, pero esa afirmación no sustituye un presupuesto: el anuncio no permite calcular por sí solo cuánto pagará un proyecto mexicano.
La biblioteca anunciada reúne más de 2,000 voces listas para producción, según Google, y los modelos admiten más de 100 idiomas. La empresa menciona variantes como español mexicano, francés de Quebec e inglés escocés. El repertorio amplio no demuestra que cada voz pronuncie correctamente un apellido, una localidad o un término técnico; esas palabras deben revisarse en la pieza final.
El diseño de voz permite describir características mediante instrucciones de lenguaje natural. También se pueden dirigir aspectos de la interpretación, como ritmo, tono y pausas, línea por línea. Es parecido a dar indicaciones en una cabina: elegir una voz es el primer paso, pero el guion y la escucha posterior siguen determinando si el mensaje se entiende.
Google plantea usos en audiolibros, podcasts, videojuegos y agentes conversacionales. Ambos modelos pueden trabajar escenas con dos hablantes a partir de un guion, de acuerdo con el anuncio. La utilidad para una redacción o un pequeño negocio debe comprobarse con su propio contenido, sin convertir demostraciones del proveedor en evidencia de rendimiento en cualquier situación.
Otra función anunciada es replicar perfiles vocales desde una muestra de 30 segundos. La empresa precisa que debe tratarse de la voz propia o de una sobre la que se tengan derechos, y que exige una grabación de consentimiento del titular. El dato no autoriza a utilizar audios ajenos de redes sociales ni a imitar a una persona pública sin permiso.
La compañía indica que incorpora SynthID en los audios y credenciales C2PA en el flujo de replicación, además de verificación de consentimiento. Son medidas de identificación y protección declaradas por Google, no una promesa de que todo fraude sea imposible. Para el público sigue siendo relevante conocer cuándo una narración es sintética y no una grabación de la persona atribuida.
¿Tu siguiente cápsula necesita una voz mexicana o una voz que diga bien los nombres mexicanos? Antes de producirla, conviene preparar un fragmento con fechas, cantidades y nombres difíciles, escucharlo completo y corregir el guion. Una pronunciación convincente no acredita la veracidad del contenido: en una nota periodística, los datos se verifican antes de convertirlos en audio.
El despliegue comenzó en Gemini API y Google AI Studio; las vías empresariales mediante API se anuncian para más adelante. Google también menciona Gemini Notebook y Google Vids para distintas variantes. El acceso, los costos y las funciones visibles deben confirmarse en cada cuenta. La oportunidad está en producir mejor, no en publicar una voz sin escuchar lo que realmente dice.

Te puede interesar
México prepara el lanzamiento de un satélite de telecomunicaciones para 2030
El nuevo satélite sustituirá al Bicentenario y tendrá una capacidad superior a 250 Gbps para ampliar la conectividad.
Google Pixel 11 llega a México: precio, preventa y rivalidad con iPhone 18
La serie Pixel 11 ya está en preventa en México con precios desde 22,499 pesos y venta oficial el 1 de octubre.
Muse Charm: así es el nuevo dispositivo de bolsillo con IA que prepara Meta
Meta lanza Muse Charm, un hardware compacto para ejecutar su agente de IA mediante voz y avatar en pantalla sin usar el teléfono.
Deja un comentario